當「可能發生」成為行銷語言,我們該如何理解機率
一、為什麼我會做這個實驗
這個實驗並非出自研究計畫,也沒有預設要證明什麼結論,而是我看到一段低機率事件的影片後,想知道這類結果究竟有多罕見,以及觀察的樣本數會如何影響我們的判斷。
影片引發的機率疑問
前陣子在 YouTube 看到丁特幾年前的一支影片,內容涉及抽卡與爆裝,實際結果和我對成功率的直覺有很大落差。與其只說結果不合理,我更想知道這個機率到底有多低,以及在大量嘗試之後,出現類似結果的機會有多大。
平常談到這類影片,我們很容易以自己的經驗判斷結果是否正常,但個人經驗通常不足以反映完整分佈。我因此想把原本模糊的「不可能」轉成可以計算、也可以模擬的問題。
用模擬比較個案與整體分佈
真正讓我開始寫程式的原因,是我發現自己說不清楚「不可能」對應的是百分之一、萬分之一,還是更低的機率。自己玩過的次數、身邊聽到的案例,以及留言區容易被看見的成功經驗,都不足以回答這個問題,還可能受到倖存者偏差影響。
我決定用 Monte Carlo 模擬重複執行相同實驗,將回合數提高到十萬或百萬,觀察各種結果出現的頻率,以及平常很少看到的尾端結果。這樣做可以把討論從個別經驗移到整體分佈,也讓我能具體比較不同參數造成的差異。
二、抽卡模型與實驗參數
開始模擬之前,我先把抽卡與爆裝整理成機率模型,明確定義單次成功率、每回合的試驗次數,以及實驗重複的回合數。這三個參數各自回答不同的問題,不能只憑單次機率判斷整體結果是否合理。
Draw Rate:一次成功的機率 p
Draw Rate 是每次嘗試成功的機率 p。在這個簡化模型裡,每次嘗試只有成功與失敗兩種結果,可以視為一次伯努利試驗;當各次試驗彼此獨立,而且 p 固定時,一回合的成功次數就服從二項分佈。如果遊戲有保底、連敗加成或其他狀態變動,就需要把這些規則加入模型,不能直接用固定機率代表。
Total Players:一次回合做幾次試驗 n
Total Players 是一回合內執行的試驗次數 n,可以代表一次抽幾抽、同時有多少人各試一次,或某個事件在一回合內被觸發幾次。雖然介面使用 Players 這個名稱,在模型中它實際上計算的是試驗次數。
如果關心的是「一回合裡至少成功一次」,機率會隨 n 增加而提高,等於 1 - (1 - p)^n;如果關心的是成功比例,則要看成功次數除以 n 的結果。n 越大,成功次數通常越多,成功比例反而越容易靠近 p,因此這兩種觀察不能混為一談。
Rounds:重複實驗的回合數
Rounds 表示用相同 p 與 n 重複執行實驗的回合數。我們日常接觸的幾次遊戲經驗、幾支影片或朋友分享,通常只是很少的觀察,不能代表整個分佈;增加獨立回合數,才能逐步看出各種結果出現的比例,以及偏離常見區間的情況。
這也是我決定把實驗交給電腦重複執行的原因:單次機率、每回合試驗次數與總回合數都會影響我們看到什麼,而模擬可以讓三者的差別更容易比較。
三、為什麼我選擇用 Monte Carlo 而不是只算公式
在獨立、固定機率的前提下,這個問題可以直接用二項分佈計算。我選擇 Monte Carlo 並非因為公式只能求平均,而是想觀察有限樣本如何累積成分佈,並用圖表比較常見結果與尾端結果之間的差距。
公式能算尾端,模擬讓分佈更直覺
二項分佈可以計算期望值、標準差、各種成功次數的機率,以及偏離平均值的尾端機率。這些資訊能回答某種結果有多罕見,但如果只看平均值,仍然不容易理解不同回合之間可能出現多大差距。
對我來說,模擬的用途是把這些差距直接呈現出來,讓公式中的機率對應到實際觀察次數。兩者可以互相對照,並不是只能選擇其中一種方法。
用重複抽樣觀察分佈
Monte Carlo 的做法是按照模型重複抽樣,再把每回合的結果累積起來。當回合數增加,就可以觀察哪些結果較常出現、分佈的尾端延伸到哪裡,以及某種看似特殊的結果在整體中佔多少比例。
這種呈現方式對我比只看公式更直覺,也適合用來檢查自己對低機率的理解。不過,圖表呈現的仍是模型在有限樣本下的觀察,不能直接當成實際遊戲的完整行為。
透過圖表建立機率直覺
我做這個實驗的目的,是把原本憑感覺判斷的機率問題,轉成可以反覆觀察與比較的結果。先從圖表看出分佈輪廓,再回頭理解參數與公式,對我來說比單獨背誦公式更容易建立直覺,也比較能說明低機率事件為什麼值得從樣本數的角度討論。
四、Win Rate Distribution Lab 在畫什麼
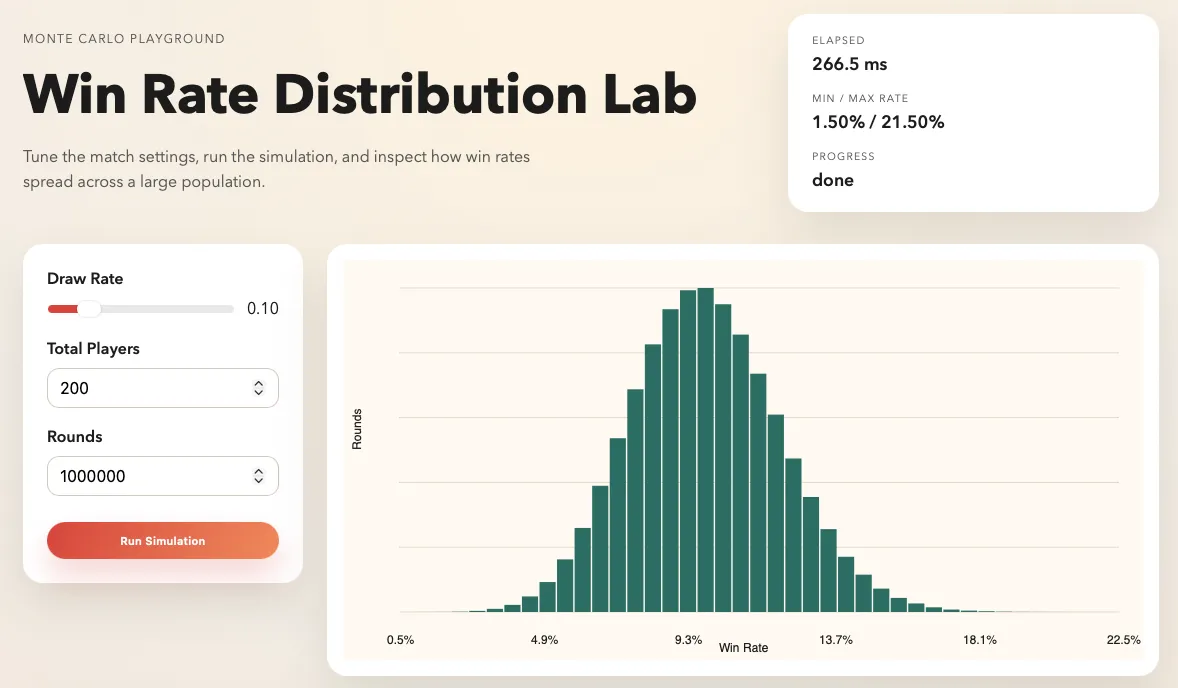
Win Rate Distribution Lab 會累積每回合的模擬結果,並用直方圖、表格與最小/最大比例呈現分佈。這三種資訊可以互相對照:直方圖用來觀察形狀,表格提供次數與比例,最小/最大值則標示這次模擬實際觀察到的範圍。
直方圖:模擬成功次數與成功比例的分佈
畫面中央最大的那張圖,是一個直方圖。
- x 軸:一回合的成功次數(wins),或換算成成功比例(win rate);下方截圖使用成功比例
- y 軸:這個成功次數,在所有 rounds 裡出現了幾次
直方圖統計的是:用相同參數重複執行實驗後,每一種結果出現了幾次。當 n × p 與 n × (1 - p) 都不太小時,分佈常會接近鐘形;成功率很低、n 又不大時,則可能在 0 附近形成明顯偏斜的高峰,不能預期每一組參數都會出現左右對稱的形狀。
表格:每個 win rate 出現了幾次
表格將目前出現過的結果整理成次數與比例,方便比較哪些結果較常見,以及尾端結果在全部回合中佔多少。主要欄位如下:
- wins:成功次數(或區間)
- win rate:換算成百分比的成功率
- rounds:這個結果出現了幾次
- share:佔所有 rounds 的比例
Min / Max Rate:觀察到的比例範圍
Min Rate 與 Max Rate 分別是這次模擬中,成功比例最低與最高的回合;它們反映的是已觀察到的範圍,而不是所有可能結果的上下界。把這兩個值和分佈高峰一起看,就能比較常見結果與極端回合之間的差距,也能觀察增加 rounds 後,樣本範圍如何改變。
五、設定參數並觀察模擬結果
實際操作時,可以先選一個想了解的成功率,再固定其他參數重複模擬,觀察分佈隨回合數累積的變化。先建立一組容易比較的基準,再逐次調整參數,會比同時改動所有數值更容易看出差別。
設定實驗參數
在 Win Rate Distribution Lab 裡,設定實驗其實就是調三個數字:
- Draw Rate:每一次嘗試成功的機率
- Total Players:一個回合裡會做幾次嘗試
- Rounds:整個實驗要重複跑幾次
你可以直接把影片裡提到的成功率丟進來,也可以故意調得更低一點,看看分佈會怎麼變形。
當你按下「Run Simulation」,後端就會開始用 Monte Carlo 的方式,一回合一回合地幫你把結果堆起來。
分佈高峰與常見結果
回合數逐步增加後,直方圖通常會呈現較穩定的高峰,表示某些結果在這組參數下較常出現。成功率很低、每回合試驗次數又少時,高峰可能集中在 0 附近;參數適合時,則會看到接近鐘形的輪廓。
這個高峰提供了理解模擬結果的基準,讓我們能比較平常看到的個案與常見區間相差多少。影片或社群討論容易集中在特殊結果,而模擬可以把較少被注意到的一般結果一起呈現出來。
回合數與極端值的出現機會
增加 rounds 後,常見結果的比例通常會逐漸穩定,同時也更有機會觀察到尾端結果。假設某種極端結果在每回合的機率是 q,執行 R 個獨立回合後,至少看見一次的機率是 1 - (1 - q)^R;當 0 < q < 1 時,這個機率會隨 R 增加而提高,但任何有限的 R 都不保證一定出現。
因此,單一玩家很少遇到的結果,放進大量回合中可能就比較容易被看見。這說明了觀察規模的重要性,也提醒我們不能把「模型容許發生」和「這次必定看得到」當成同一件事。
六、比較平均值與觀察到的極端值
平均值是理解分佈的重要基準,但我在這個實驗中更關心最小與最大成功次數,因為抽卡與爆裝的討論往往圍繞個別回合的落差。將這些值放回整體分佈,比只看單一平均數更能說明不同經驗之間的差距。
平均值沒有呈現的差距
平均值把全部回合的結果集中成一個數字,適合用來描述整體水準,卻不會告訴我們不同回合之間的差距。如果想知道為什麼某次特別順利、某次卻幾乎沒有成功,就需要一起查看分佈的形狀與尾端,而不是只用平均值判斷結果是否正常。
Min Wins:最小成功次數
Min Wins 是所有已完成回合中,觀察到的最小成功次數,可以用來了解這次樣本裡較差的結果落在哪裡,以及和常見區間相差多少。當成功率很低時,最小值也可能只是很常見的 0 次成功,仍要搭配整張分佈判讀。
有些看起來不合理的結果,在模型裡也可能出現,但這還不能證明實際遊戲的機率或實作沒有問題。要判斷真實系統,仍然需要確認公告機率、資料取得方式,以及遊戲規則是否符合模型的前提。
Max Wins:最大成功次數
Max Wins 則是這次樣本中觀察到的最大成功次數,代表結果較好的一端。它和平均值、Min Wins 一起呈現時,可以看出不同回合的差距,也能避免只憑某次成功率特別高的個案,推斷所有人都應該有相同體驗。
我希望這個模擬能提供的是比較個案的背景,而不是替任何一方判定對錯。把常見結果與極端結果放在一起,才比較容易討論觀察到的差距究竟有多大。
七、工程實作:即時呈現模擬結果
實作時,我希望模擬過程中的分佈就能持續顯示,而不是等全部回合完成後才回傳結果。這樣既能讓使用者知道計算進度,也方便觀察樣本累積時,常見區間與尾端結果如何改變。
為什麼不用等全部跑完
最直接的做法,是由後端完成全部回合,再一次回傳結果讓前端繪圖,但在幾十萬或上百萬回合的情況下,使用者只能等待,也無法觀察分佈形成的過程。我因此把模擬拆成小批次,每完成一批就回傳目前狀態,讓進度與分佈可以持續更新。
Server-Sent Events(SSE)在做什麼
批次結果透過 Server-Sent Events(SSE) 傳給前端。SSE 讓伺服器可以在同一條串流連線中持續推送資料,不需要前端反覆查詢;在這個專案中,每完成一個 batch,就會送出目前的狀態,包含以下資訊:
- 目前累積的 counts
- 已完成的進度比例
- 已經花了多久時間
- 當下的最歐與最非
前端接收這些狀態後即可更新畫面,不必等整個實驗完成。
前端如何即時重繪分佈
前端收到批次結果後,會更新直方圖、表格與統計數字,主要流程如下:
- 接收 SSE 傳來的新資料
- 把最新的 counts 畫成直方圖
- 同步更新表格與指標數字
每次更新都對應到新增的模擬資料,因此畫面呈現的是實際樣本累積的過程。使用者除了看到目前進度,也能比較分佈在不同階段的變化,這是我採用即時呈現而不是完成後一次繪圖的主要原因。
八、為什麼用 Rust(但我也保留了 Python 版)
這個專案保留 Python 與 Rust 兩個版本,Python 方便修改參數與檢查模型,Rust 則用來執行較大的樣本與部署工作。兩個版本在這個專案中的用途不同,並不是用單一語言取代所有工作。
當 rounds 拉到百萬等級會發生什麼事
一開始我只是想跑個幾萬次看看分佈,大概長這樣:
rounds = 10_000較小的回合數可以先用來檢查程式的基本行為;為了觀察更少見的結果,我再把回合數提高到:
rounds = 1_000_000這時候差異就出現了:
- 單次模擬裡有 total_players 次隨機試驗
- 總判斷次數約為 rounds × total_players;例如一百萬回合、每回合 200 次,就是兩億次
- 再加上還要即時更新分佈
因此,回合數提高時,除了觀察結果,也要評估隨機試驗的計算成本與更新畫面的頻率。
Rust:執行大量隨機試驗
Rust 版維持相同的抽樣模型,逐回合統計成功次數,再累積到 counts 陣列;程式的計算量與回合數、每回合試驗次數直接相關。
以下是 Rust 版簡化後的核心模擬函式,使用 rand 0.9:在 Cargo.toml 的 [dependencies] 加上 rand = "0.9",並匯入 Rng 與 SeedableRng。這是單次函式範例,未包含 Web server、批次推送或取消機制;請先從小參數開始。
use rand::{Rng, SeedableRng};

fn run_simulation(draw_rate: f64, total_players: u32, rounds: u32) -> Vec<u32> {
    assert!(draw_rate.is_finite() && (0.0..=1.0).contains(&draw_rate));
    assert!(total_players > 0 && rounds > 0);

    let slots = usize::try_from(total_players)
        .ok()
        .and_then(|n| n.checked_add(1))
        .expect("total_players is too large");
    let mut counts = vec![0u32; slots];
    let mut rng = rand::rngs::SmallRng::from_os_rng();

    for _ in 0..rounds {
        let mut wins = 0u32;
        for _ in 0..total_players {
            if rng.random_bool(draw_rate) {
                wins += 1;
            }
        }
        counts[wins as usize] += 1;
    }

    counts
}
在實際專案裡,我還多做了幾件事:
- 使用 SmallRng,減少隨機數生成的成本
- 把模擬丟進 spawn_blocking,避免卡住 async runtime
- 拆 batch,用 SSE 把結果一段一段推給前端
這個版本的成本與執行方式可以整理成以下幾點:
- 時間成本約為 O(rounds × total_players),counts 的記憶體約為 O(total_players)
- 把計算移出 async worker,可減少阻塞;服務仍須限制參數與同時執行的任務數
- 行為非常可預期,適合做這種爆破型實驗
Python:可讀性與快速驗證
我仍保留 Python 版作為驗證模型與快速實驗的工具;它的流程容易對照機率模型,也方便修改參數、加入輸出檢查。對應的模擬函式如下:
import random

def run_simulation(draw_rate, total_players, rounds):
    if not 0.0 <= draw_rate <= 1.0:
        raise ValueError("draw_rate must be between 0 and 1")
    if total_players <= 0 or rounds <= 0:
        raise ValueError("total_players and rounds must be positive")

    counts = [0] * (total_players + 1)

    for _ in range(rounds):
        wins = 0
        for _ in range(total_players):
            if random.random() < draw_rate:
                wins += 1
        counts[wins] += 1

    return counts
這兩個版本使用相同模型:每回合執行 total_players 次試驗,統計成功次數,再累積各種結果出現的次數。Python 版適合進行小規模試跑與模型調整,Rust 版則用來執行較大的樣本與部署工作;如果只想在本機觀察分佈,從 Python 版和較小的 rounds 開始就可以。
九、跨平台發佈與實際部署
模擬與即時呈現可以正常執行後,我把專案整理成可直接執行的發佈版,也保留原始碼與編譯設定,方便在不同環境使用或繼續修改。
Apple Silicon / Windows / Ubuntu 發佈版
我有把 Rust 版整理成三個平台的發佈版本:
Mac上如果無法執行,請開啟終端機並執行以下指令
xattr -d com.apple.quarantine /path/to/win_rate_distribution && chmod +x /path/to/win_rate_distribution
這裡提供兩個檔案,分別包含後端與模擬邏輯,以及相依套件與編譯設定:
如果你想快速理解程式在幹嘛,可以用這個順序看:
- main.rs 的 router 設定
- /、/styles.css、/app.js:前端畫面
- /api/simulate:一次性模擬
- /api/simulate/stream:SSE 串流模擬
- 模擬核心邏輯
- 用隨機數跑大量 rounds
- 累積每個 wins 出現的次數
- 不斷回傳目前的分佈狀態
- 非同步 + blocking 的分工
- Web server 維持回應
- 模擬丟給 blocking task 跑
- 將 Web 請求與模擬計算分開安排
這樣分工是為了讓模擬工作和 Web 請求分開處理;實際可承受的工作量仍取決於硬體資源、參數範圍與任務數量。
HTTPS、自簽憑證與本機測試
為了讓本機測試的通訊協定接近線上環境,我選擇用 HTTPS 跑整個服務。SSE 本身不要求 HTTPS;HTTP 也能使用 EventSource,但 HTTPS 頁面不應連到 HTTP 串流,以免遭到混合內容限制。
這裡用的是:
- 自簽憑證(self-signed certificate)
- 啟動時會自動簽署憑證
自簽憑證通常不在瀏覽器的信任清單中,因此本機測試可能看到憑證警告。這種方式只適用於能確認服務來源的本機測試,公開服務仍應使用受信任的憑證;測試時也會一起確認下列項目:
- 頁面與串流使用相同的通訊協定,減少本機與線上的差異
- 確認憑證信任、跨來源規則與代理緩衝,不把串流問題都歸因於 SSE
線上試玩
如果你只是想體驗,不想自己跑環境,我也把整個專案部署成線上版本:
你可以直接在瀏覽器裡:
- 調參數
- 跑模擬
- 看分佈怎麼長出來
如果想比較其他情境,也可以下載原始碼調整模型;下面整理幾種固定部分參數、逐次改變另一個參數的觀察方式。
十、參數調整與結果比較
使用這個工具時,我通常固定部分參數,只改變其中一個值,再比較結果。這樣比較容易分辨變化來自成功率、每回合試驗次數,還是總回合數;下面是我常用的三組觀察方式。
固定成功率,增加 rounds 看分佈如何收斂
第一個玩法最單純,也最適合當起手式。
- 固定一個成功率(draw rate)
- 固定一次回合的試驗次數(total players)
- 只調整 rounds,例如:
- 10,000
- 100,000
- 1,000,000
固定 p 與 n,增加 rounds 時,各種成功次數的觀察比例通常會逐漸穩定,直方圖也更接近模型分佈。這是用抽樣觀察大數法則的一種方式;有限次模擬本身不是數學證明,但能協助比較樣本數不足與較充足時的差異。
固定成功率,增加試驗次數比較數量與比例
第二組比較固定成功率與回合數,觀察每回合試驗次數改變時,成功數量與成功比例的差別:
- 固定 draw rate
- 固定 rounds
- 慢慢把 total players 往上加
固定 p 和 rounds、增加每回合的 n 時,成功次數的標準差是 √(n × p × (1 - p)),數量上的波動會變大;成功比例的標準差則是 √(p × (1 - p) / n),反而會變小,因此每回合抽得越多,成功比例通常越接近設定的 p。這和固定 n、增加 rounds 以觀察更多極端回合,是兩種不同的比較方式。
調低成功率,比較分佈與尾端
第三組比較固定 n、使用較大的 rounds,再逐步調低 draw rate。隨著成功率降低,分佈高峰通常會往較少成功的方向移動;右側仍可能有成功次數較多的回合,但它們的比例與出現機會也會隨參數改變。
這種比較可以讓「機率很低」對應到具體的次數與比例,而不是只憑某次成功或失敗推斷整體結果。觀察尾端時,也需要連同樣本規模一起看,才不會高估單一個案的代表性。
結語:從分佈理解低機率與付費風險
這個實驗讓我更清楚地區分「低機率」與「不可能」:在模型中有機會出現的結果,未必會在有限的樣本裡被觀察到,而大量重複試驗能幫助我們理解它在整體分佈中的位置。更值得討論的,是這些機率資訊如何被呈現,以及它們會怎樣影響玩家的判斷與付費決策。
你看到的只是分佈的一小塊
Monte Carlo 可以逐步呈現模型的分佈輪廓,讓常見結果與較少出現的尾端結果一起被看見;但我們在影片、廣告或個人經驗中接觸到的,往往只有其中一小部分。成功案例和失敗經驗都可能是真實的,卻未必能代表整體,因此比較個案時,仍需要知道它們來自多大的樣本、佔全部結果多少比例。
模型結果與實際系統的差別
在獨立、固定機率的模型裡,各回合遵循相同抽樣規則,仍然可能得到不同結果。有些回合成功次數較多,有些較少,這些差距需要放回分佈裡判讀,而不能只用單次經驗推斷機率是否改變。
模型提供的是理解差距的參考,不是對現實系統的驗證。回到實際遊戲時,仍然需要檢查公告機率與實作是否一致,以及活動規則是否包含保底或其他狀態變化。
當「可能發生」變成行銷語言
「可能發生」可以描述單次機率 20% 的相對常見結果,也可以描述 0.01% 這類很少出現的事件。如果宣傳只強調有人成功,卻沒有交代機率、嘗試次數與整體分佈,玩家就容易把個案當成自己也很容易遇到的經驗。這是我認為值得檢視的資訊落差,常見的呈現方式包括以下幾種:
- 宣傳把鏡頭對準分佈的尾巴:社群貼文、廣告素材、直播精華、短影音——最適合被拿來傳播的永遠是「有人抽到」、「一發入魂」、「超歐瞬間」。這些都是真實事件,但它們在整體分佈裡通常是非常細的尾巴。把尾巴當主菜,玩家自然會誤判整體長相。
- 把「個案」包裝成「你也可以」:很多行銷不會明講「你一定抽得到」,但會用暗示式敘事:「只要參與就有機會」、「下一個就是你」、「祝你一發畢業」。這些句子不構成保證,卻會讓消費者在心理上把自己往分佈右側靠攏——而且越在情緒高點越容易發生。
- 用『隨機』掩蓋『資訊缺席』:「一切都是隨機」本身是描述機制,不是解釋體驗。如果你不提供合理的量化資訊(例如機率、期望成本、分佈區間),那玩家無從判斷自己到底是在跟什麼規模的風險互動。這時候「隨機」就會變成一個很方便的結語:講完就收,拒絕溝通。
- 把玩家的直覺缺口變成變現空間:抽卡機制的商業強度,很大一部分是建立在「人類不擅長直覺理解低機率」這件事上。當業者知道玩家會高估自己成為歐皇的機率、低估落入尾巴左側的成本時,宣傳只要一直把歐的片段推到你面前,玩家就會更難冷靜評估。
我認為需要檢視的是,宣傳是否只用「可能發生」帶過發生機會有多小,進而讓玩家誤判自己承擔的風險。某個結果在統計上可能出現,不代表只展示這個結果就能充分說明付費活動;機率、成本與常見區間應該一起被納入溝通。
扭蛋法與機率揭露:制度試圖補上的那一塊
抽卡與轉蛋涉及付費取得隨機結果,玩家需要在消費前了解獎項、條件與機率,才能判斷活動是否符合自己的期待。只說「稀有道具限時登場」或「有機會獲得」,並不足以讓人比較不同活動的風險,這也是機率揭露與相關制度討論需要處理的資訊不對稱。
以臺灣為例,《網路連線遊戲服務定型化契約應記載及不得記載事項》已要求適用範圍內的付費機會中獎商品或活動揭露中獎機率百分比等資訊。在這個基礎上,我希望揭露內容能更容易被理解、比較與驗證,下面幾點是我對更完整資訊的建議,並非每一項都是現行法定要求。
- 單次機率的透明:最基本的:每一個獎項或每一個稀有度到底是多少機率。至少讓玩家知道 1%、0.1%、0.01% 是不同世界。
- 不同條件下的機率變化:很多機制會有「活動加成、階段式池子、保底、分段權重、抽到某物後機率調整」等設計。如果只揭露一個靜態百分比,而實際上機率會隨狀態改變,那玩家拿到的仍然不是完整資訊。
- 期望成本與分佈的概念(不是只給平均):只公布單次機率還不夠,因為玩家真正的問題是:「我大概要花多少?」但平均值又很容易誤導(因為尾巴很長)。更好的揭露方式應該讓玩家理解「常見區間」與「尾巴風險」:例如「抽到目標在 50% 的玩家需要多少抽」、「90% 的玩家需要多少抽」之類的分位數資訊(或等價呈現)。
- 可驗證性:玩家如何知道它真的照這個機率跑:這是最敏感也最重要的一層。如果機率揭露只是公告,但玩家無法用任何方式驗證「公告 ≈ 實際」,那就會永遠停留在信任問題。制度之所以被討論,很多時候正是因為市場機制缺乏可驗證性,導致「信者恆信、不信者恆不信」。
我期待制度能讓玩家在理解風險的前提下決定是否參與,而不是只在看到特殊成功案例後付費。更完整的分佈、成本與機率資訊不需要保證每個人都能抽到目標,但應該協助消費者知道自己購買的是什麼,以及可能承擔多少不確定性。
工具與模擬能做的,不是替誰背書
Win Rate Distribution Lab 的用途,是把抽象的機率轉成可以觀察與比較的分佈,讓個案有更完整的背景。它不能替任何遊戲公司證明機制公平,也不表示玩家面對不合理結果就應該接受;我希望它能幫助讀者在評估風險時,多一份具體的參考。
將模型用於其他情境
如果想驗證其他抽卡、爆裝、掉寶率或勝率情境,可以先確認是否符合獨立、固定機率的模型,再調整參數比較結果。連敗次數、保底與動態機率需要額外記錄狀態並修改規則,不能只調整這三個參數。理解模型適用的範圍,才能讓模擬結果成為有用的判斷依據。
附錄:專案結構與資料流
下面從資料流的角度整理後端模擬、SSE 狀態快照與前端 Canvas 的分工,作為對照原始碼時的閱讀順序;各個步驟的詳細程式則可以參考前面提供的原始碼。
後端模擬流程
後端接收實驗參數後,負責執行大量隨機試驗、累積各種成功次數的出現頻率,並定期送出狀態。主要流程如下:
- 接收參數
- draw rate(單次成功機率)
- total players(一次回合的試驗次數)
- rounds(要跑幾回合)
- 初始化統計結構
- 建立一個 counts 陣列
- index 代表成功次數(wins),value 代表出現次數
- 進入大量迴圈
- 每一回合模擬 total_players 次隨機試驗
- 計算該回合的 wins
- 對應的 counts[wins] += 1
- 批次化執行(batch)
- 不一次跑完所有 rounds
- 每跑完一小批,就整理一次目前的分佈狀態
- 回傳中間結果
- 計算目前的 min / max wins
- 計算進度與耗時
- 將 snapshot 丟給前端
批次化讓中間結果可以定期回傳,計算任務則與 Web 請求分開處理;配合參數範圍與任務數量限制,才能在較大的樣本量下維持可回應的服務。
Stream payload 設計
後端每次透過 SSE 推送的是目前狀態的快照,前端可直接用它更新畫面,而不必先重建先前的累積過程。概念上包含以下欄位:
- counts:目前累積的成功次數分佈
- progress:完成進度(0~1)
- elapsed_ms:目前已耗時多久
- total_players / total_rounds:實驗參數
- min_wins / max_wins:目前觀察到的極端值
- done:是否已完成全部 rounds
由於每包資料已包含累積結果,繪圖不需要保留全部歷史事件;如果要在斷線後接續同一次模擬,後端還需要保存任務與事件進度,單靠 SSE 自動重連並不足以完成。
前端 Canvas 與互動細節
前端使用後端提供的 counts 更新圖表與互動,不在瀏覽器中重跑模擬,主要分工如下:
- Canvas 繪圖
- 把 counts 當成直方圖資料
- 動態計算 bar width、高度比例
- 自動根據 min / max wins 調整可視範圍
- 互動處理
- 滑鼠 hover 時,反算目前指到的是哪個 wins
- 高亮對應的 bar
- 同步標示下方表格的列
- 狀態同步
- SSE 每來一包資料就重繪一次
- 視窗 resize 時重新計算比例
- 模擬完成後自動解除鎖定按鈕
整個前端刻意不依賴任何大型圖表套件,我希望它的行為是完全可控、沒有黑盒子的。